انوالع ال Machine Learning بالتفصيل
شرح مبسط لأنواع Machine Learning، والفرق بين Supervised Learning وUnsupervised Learning وReinforcement Learning وSemi-Supervised وSelf-Supervised، مع أشهر استخداماتها وخوارزمياتها.
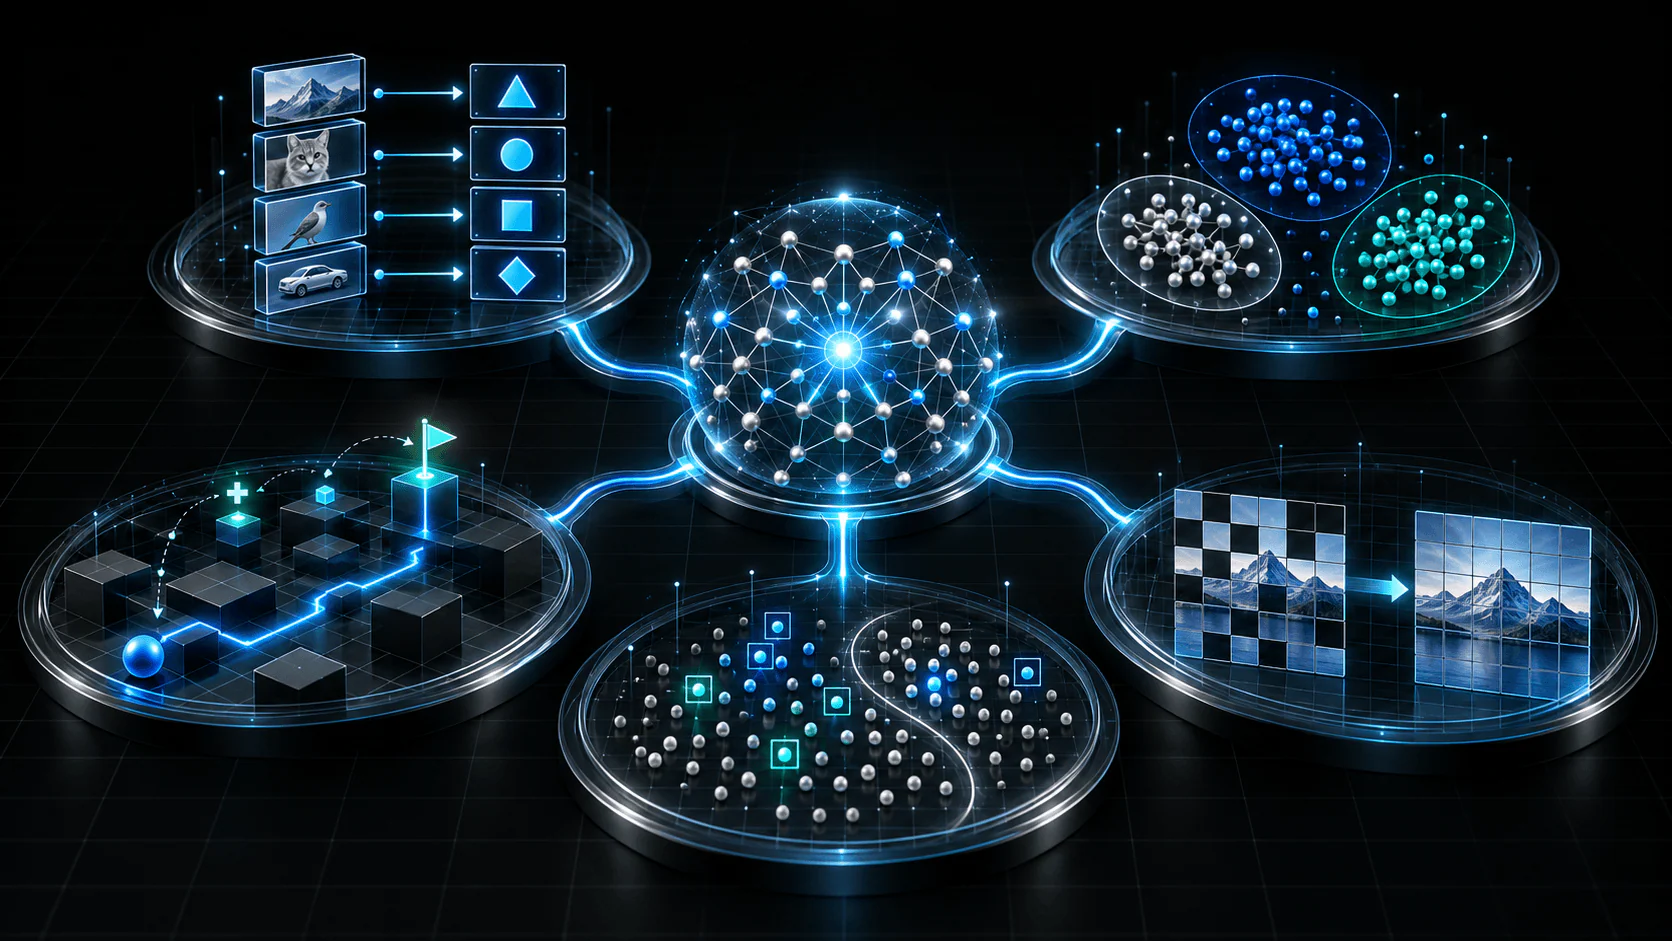
طبعًا إحنا اتكلمنا في الجزء الثاني من سلسلة Machine Learning عن أنواع البيانات وتجهيزها وEmbeddings ولكن في حاجة مهمة جدًا إحنا أصلًا متكلمناش عنها، وهي أنواع الـ Machine Learning.
الـ Machine Learning له أنواع كتير مشهورة ومستخدمة كتير، زي:
- Supervised Learning
- Unsupervised Learning
- Reinforcement Learning
وفي أنواع موجودة تانية، زي:
- Semi-Supervised Learning
- Self-Supervised Learning
نمسك واحد واحد فيهم ونفصصه ونتكلم بالتفصيل عنهم.
1. Supervised Learning
الـ Supervised Learning بيعتمد على الـ Labeled Data، يعني في Features وهي دي الـ Inputs، وفي Target وده هو اللي بنعمل عليه الـ Prediction.
فالـ Supervised Learning بيتعلم من الاتنين دول مع بعض، عشان يفهم العلاقة اللي بينهم.
في حاجتين أساسيتين في الجزء بتاع الـ Supervised Learning، لأنه مقسوم لحتتين:
- Regression
- Classification
Regression
الـ Regression هو التنبؤ بحاجة رقمية، زي مثلًا لو عايزين نتوقع سعر بيت أو محتاجين نتوقع مثلًا الشهر الجاي.
في خوارزميات خاصة بالـ Regression، زي:
- Linear Regression
- Polynomial Regression
- Ridge and Lasso Regression
- Decision Tree Regression
- Random Forest Regression
Classification
الـ Classification هو التنبؤ بفئة معينة، وبيكون فيه حاجتين:
- Binary Class: وده بيتوقع فئتين بس، زي مثلًا رجل أو ست.
- Multi-Class: وده بيتوقع أكتر من فئة، زي اللون الأحمر أو الأخضر أو الأزرق وهكذا.
في خوارزميات طبعًا للـ Classification، زي:
- Logistic Regression
- Support Vector Machines (SVM)
- Random Forest Classification
- K-Nearest Neighbors (KNN)
- Naive Bayes
2. Unsupervised Learning
الـ Unsupervised Learning بيعتمد على الـ Unlabeled Data، يعني الداتا فيها الـ Features وهي دي الـ Inputs، ولكن مفيهاش الـ Target وده هو اللي بنعمل عليه الـ Prediction.
الـ Unsupervised Learning مقسوم جواه شوية حاجات:
- Clustering
- Dimensionality Reduction
Clustering
الـ Clustering بيهدف لتجميع الفئات المتشابهة في حتة واحدة.
وفي خوارزميات للـ Clustering، زي:
- K-Means
- Hierarchical Clustering
- DBSCAN
Dimensionality Reduction
الهدف من الـ Dimensionality Reduction إنه يبسط الداتا ويقلل الأعمدة، لو فيه أعمدة كتير، لأعمدة قليلة، ويحافظ على أهمية المعلومات، وكمان يسرّع عملية الـ Training.
وفي طبعًا خوارزميات للـ Dimensionality Reduction، زي:
- PCA (Principal Component Analysis)
- t-SNE
3. Reinforcement Learning
الـ Reinforcement Learning بقى حاجة مختلفة، لأننا مش بندي الداتا له عشان يتعلم بطريقة مباشرة.
إحنا بنحطه في البيئة دي ونحدد له هدف، وكل ما هو ياخد قرار صح ياخد مكافأة Reward، ولو غلط ياخد عقاب أو Penalty.
ومع الوقت بيتعلم ويعرف ياخد القرار اللي ياخد عليه مكافأة Reward.
4. Semi-Supervised Learning
الـ Semi-Supervised Learning حل مشكلة عبقرية جدًا، وهي إن الداتا الـ Labeled قليلة أصلًا ومكلفة، وكمان الداتا الـ Unlabeled كتيرة ومتوفرة أكتر.
يعني مثلًا الطالب ذاكر 3 صفحات كويس، وبعد كده راح للـ 500 صفحة ويتعلم منهم ويتعلم من غلطته، اعتمادًا على القواعد البسيطة اللي اتعلمها من الـ 3 صفحات.
5. Self-Supervised Learning
في الـ Self-Supervised Learning بيكون معانا Unlabeled Data، ومش معانا أي إجابات نموذجية بشرية.
وبدل ما هو يستسلم، لأ، هو بيعمل Create لإجابات، ويبدأ بقى إنه يتعلم من كده.
Written by
Mohamed Alawakey
ML & AI Engineer documenting practical decisions from building RAG, LLM, machine-learning, and FastAPI systems.