مقدمة تعلم الآلة 2: أنواع البيانات وتجهيزها وEmbeddings
أنواع البيانات في تعلم الآلة ومصطلحات تجهيزها: Features وLabels وData Leakage وValidation وEmbeddings، بشرح مبسط وأمثلة عملية.
طيب في حاجه عايزين نتكلم عنها بدقه كده شويه استكمالا للجزء الاول تقدر توصله من هنا
احنا قولنا ان الموديلز بتتدرب علي كذا نوع من الداتا قولنا منها ال text, images, numbers, videos !! خد بالك الكلام ده اصلا هو متقسم
يعني اي متقسم ؟
يعني في اصلا كذا نوع من الداتا:
- structured data ودي بتكون عباره عن داتا متهندله وبتكون جوه جداول وصفوف واعمده ودي ممكن تشمل numbers و text عادي ودي بتكون بتتخزن فحجات زي زي ال SQL DBs زي PostrgreSQL او SQLServer او MariaDB او غيرهم زي ال Excelو CSV
- unstructured data ودي بتشمل بقا text ضخم او images او videos ودي بتكون بتتخزن في NoSQL أو Object Storage أو File Systems زي MongoDB و Redis و new4j وغيرهم وخد بالك ان ممكن برده التخزين ف JSON برده فاهم
- semi structured data ودي بتكون مزيج بين ال structured data وال unstructured data زي JSON و XML وغيرهم
طيب يعني احنا هناخد الداتا بيز دي بقا نخلي الموديل يتدرب عليها ؟
بالظبط كده وساعات كمان بنقول مصطلح Data Set وهو ده الملف بتاع الداتا بتاعناوخد بالك مش لازم يبقى File يعني المهم ده هو الي هنخلي الموديل يقرا منه ويتعلم من خلاله وطبعا يعني بالبروسيس الي كنا عمالين نتكلم فيها
خد بالك في شويه حجات برده عايزك تكون فاهمهم بخصوص البايبلاين بتاع ال data processing الي هم:
- كلمه Sample لما تسمعها دي معناها عينه من الداتا الي معانا ممكن يكون عنصر محدد براحتنا عادي او ممكن تكون عينه عشوائيه عادي وكل Row اسمه Sample
- كلمه Feature والكلمه دي معناها اسم العمود بتاعنا الي هو اسم العمود يعني في مثلا عمود اسمه Age وواحد اسمه Salary وهكذا فاهم
- كلمه Target وهو ده العمود الي احنا اصلا بنعمل ال ML بتاعنا عشان نقدر نتوقع ونطلع نتايج زي الموجوده فيه وركز لان العمود ده في حالات فال ML مش هيكون موجود فيها سواء بقا انت هتضطر تعمله وتستنجه بنفسك او هيكون ال use case دي حاجه زي ال Unsupervised Learning وده متشغلش بالك بيه دلوقتي ولكن خليك عارف المعلومه كده لغايه لما نيجي قدام وهفهمك كل حاجه
- كلمه Input وطبعا دي الي بيكون المدخل الي بيدخل لل ML Model وال Output هو ده الي الموديل بيطلعه بقا وبيكون مبني علي ال Target الي هو ال prediction بتاعنا
- كلمه Label هو القيمة الحقيقية للـ Target يعني لو عندى
Age Salary Bought
20 5000 Yes
يبقى Features:  , Age, Salary, Target, Bought
Label: Yes
- كلمه Ground Truth ودي بتكون كلمه معبره عن ال highly accurate, verified information الي بنستخدمها ك benchmark عشان ن train, validate, and test الموديل بتاعنا
- كلمه Numerical Features ودي بتكون معبره عن ال Features الي الداتا جواها رقميه
- كلمه Categorical Features ودي يعني الداتا بتكون جوه ال Features بشكل نصي
- كلمه Record وهي بتكون الاماكن الموجود فيها الداتا يعني ال Record = Row وكمان عشان تكون عارف: Record = Observation = Instance = Sample
- كلمه Missing Values يعني في Record عندنا فالداتا مفهوش قيمه
- كلمه Outliers ودي يعني في قيم كبيره جدا جدا فالداتا عندنا اكبر اصلا من الحد الطبيعي او المنطقي حسب كل case بنكون فيها
- كلمه Noise يعني وجود معلومات عشوائية أو أخطاء أو إشارات مش بتمثل العلاقة الحقيقية
- كلمه Duplicate Data يعني الداتا مكرره وفالحاله دي لازم نفهم الاول هل هنشيلها ولا هنسيبها لان هي اصلا ممكن تكون معبره عن حاجه او علاقه فالداتا
- كلمه Normalization ودي بتكون معبره عن التحجيم يععني بنخلي الداتا متحجمه في range معين فالداتا فتكون الداتا فنطاق واحد بيكون (0 و 1) أو (-1 و 1) حسب الطريقة المستخدمة
- كلمه Standardization ودي بنخلي فيها الداتا يكون المتوسط الحسابي ب 0 والانحراف المعياري ب 1 وده بيخلي في عدل وبتخلي ال machine learning Algorithms تتعلم اسرع وادق بكتير
- كلمه Encoding وهي تحويل الداتا الغير الرقمه والغير مفهومه للموديل لصوره رقميه الموديل يقدر يفهمها وبيكون ليها انواع زي ال One Hot و Label Encoding و Ordinal Encoding
- كلمه One Hot دي طريقه processing بتعالج ال Categorical Data وتحولها لكلام مفهوم لل Model وفكرته انه بيمسح العمود القديم وبيكريت عمود جديد لكل كلمه ويحط 1 عند الكلمة اللي موجودة و 0 عند الباقي "بتنشئ أعمدة Binary جديدة وبتمسح الاساسي"
- كلمه Label Encoding ده بقا Technique بنستخدمها انها تدي لكل ليبل عندنا رقم فلو عندنا 3 ليبلز مثلا مرسيدس وميتسوبيشي ولانوس فهيدي لكل واحد رقم المرسيدس 1 والميتسوبيشي 2 واللانوس 3 ولكن المشكله بق هنا انه ممكن يدي اهتمام اكتر بالارقام الاكبر وكده وده هيعمل مشكله طبعا لان هيكون في اهتمام بالجزء الاكبر وده غلط ومش لازم يديهم الارقام بالترتيب زي المثال الي انا قولته
- الكلمه Ordinal Encoding ده بقا Technique بنستخدمه لما يكون الكلام اللي في الداتا مش عشوائي لا كلام فيه رتب ودرجات أو ترتيب منطقي (Ordered Data)
- كلمه Train Test Split ودي عمليه اساسيه بنعملها عشان نقسم الداتا بتاعنا لجزئين ال training, testing
- كلمه Data Leakage ودي عباره عن إن الموديل شاف معلومات أثناء التدريب كان المفروض ميشوفهاش، وبالتالي بيطلع نتائج ممتازة وهمية
- كلمه Validation Set فالتدريب بنقسم الـ Training Data إلى Training و Validation ونستخدم الـ Validation لاختيار أفضل Model أو Hyperparameters وبعد ما نخلص فعلاً ممكن نعيد تدريب أفضل موديل على Training+Validation قبل الاختبار النهائي
- كلمه Parameters دي الحاجات اللي الخوارزمية بتتعلمها وتعدلها لوحدها من الداتا أثناء التدريب (زي الأوزان W والانحياز b) أنت مالكش تدخل فيها
- كلمه Hyperparameters دي الإعدادات اللي أنت بتفرضها على الخوارزمية من بره عشان تحدد هي هتتعلم إزاي وبأي سرعة
- كلمه Cross Validation ودي طريق بنستخدمها عشان نعمل evaluation متقطع وذكي ونبتاكد من خلاله انه الموديل قادر يتعامل مع داتا جديده عليه
- كلمه ال Feature Selection ودي اننا بنعمل اختيار لل Features المهمه والمؤثره عندنا من الداتا عشان منشتتش الموديل بداتا مش مفيده
- كلمه Feature Engineering ودي بقا العمليه الي بنعملها لما نحب نطلع ب Feature جديده سواء هتكون من استنتاج او هتكون من Features موجوده عندنا اصلا ونطللع احنا Features جديده من ال Features دي
- كلمه Pipeline ودي عباره عن المسار الكامل الي بنمشيه عموما زي مثلا CSV -> Cleaning -> Encoding -> Scaling -> Training -> Evaluation -> Prediction
- كلمه Loss Function ودي الموديل فيها بيتوقع ولو توقع غلط بنحسب مقدار الخطا والمقدار ده اسمه Loss وده مهم جدا عشان الموديل يحاول يقلله مع كل Training ولو فضل يقلل الـ Loss مرة بعد مرة يبقى هو بيتعلم وده اصلا بيدخلنا علي ال Gradient Descent وكام في ملاحظه تاخد بالك منها هنا وهي ان ال Loss بيقيس مدى خطأ الموديل وقت التدريب، فحين Metrics زي Accuracy بتقيس الاداء بعد التوقع
- كلمه ال Gradient Descent وده Optimizer بنستخدمه بقا عشان نفضل نقلل ال Loss لاقل ما يمكن (Minimum Loss) خليك برده عارفه دلوقتي عشان هنتكلم عنه قدام لسه
- كلمه Underfitting ودي عكس كلمه ال Overfitting الي شرحناها فوق ودي بقا ان الموديل ميكونش متعلم بطريقه كافيه ومتعلمش العلاقه اصلا الي بين الداتا
- كلمه Bias ودي يعني الانحياز يعني الموديل هيكون منحاز جدا ومن المنظور الرياضي فهو مدي الابتعاد بتاع متوسط النتيجه المتوقعه عن النتيجه الحقيقيه الي بيحاول يتوقعها ودي اصلا كمان بتكون معبره عن ان الموديل عنده Underfitting لو هي عاليه
- كلمه Variance ودي يعني مدى تغير توقعات الموديل عند تغذية موديل جديد بداتا تدريب مختلفة ويعني أن الموديل معقد جدا وحفظ داتا التدريب بدقتها وتفاصيلها بما فيها من الضوضاء أو العشوائية وكمان دي لما بتكون عاليه بيكون الموديل عنده Overfitting
- كلمه Generalization ودي بقا يعني الموديل عنده القدره انه يعمم يعني هو كويس جدا وعارف يفرق وبيتوقع صح والكلام ده لما بيكون دخلنا له داتا جديده حرفيا عن الحاجه الي هو اتعلمها وهو يقدر يستنتج ويشتغل كويس
- كلمه Prediction ودي بقا المصطلح الي عمالين نتكلم عنه وده هو النتيجه بتاع التوقع بتاع الموديل
- كلمه Inference ودي بقي الرد بتاع الموديل ولكن في بينها وبين ال Prediction لان دي بتشتغل فحاجه مختلفه اسمها ال LLMs هنتكلم عنها بعدين لان ال Inference ده استدلال فالفهم وفالرد لانه اعقد رياضيا عن ال Prediction
بالنسبه لحوار ال Bias وال Variance احنا بنحاول علي قد منقدر نعمل بينهم توازن بحيث ان الاتنين يكونوا اقل ما يمكن
تخيل لوحة الرماية (الهدف):
- لو Bias منخفض و Variance منخفض: كل الأسهم تصيب منتصف الهدف بدقة (الموديل المثالي)
- لو Bias عالي و Variance منخفض: الأسهم متجمعة كلها في مكان واحد، ولكنها بعيدة عن منتصف الهدف
- لو Bias منخفض و Variance عالي: الأسهم مبعثرة في كل مكان حول لوحة الرماية، لكن متوسطها قريب من المركز
- لو Bias عالي و Variance عالي: الأسهم مبعثرة وبعيدة تماماً عن المركز
وايا كان نوع الداتا الي هتعامل معاها فهي كده كده بتعدي علي ال pipeline يتاع ال data preprocessing فكده كده هتتعالج
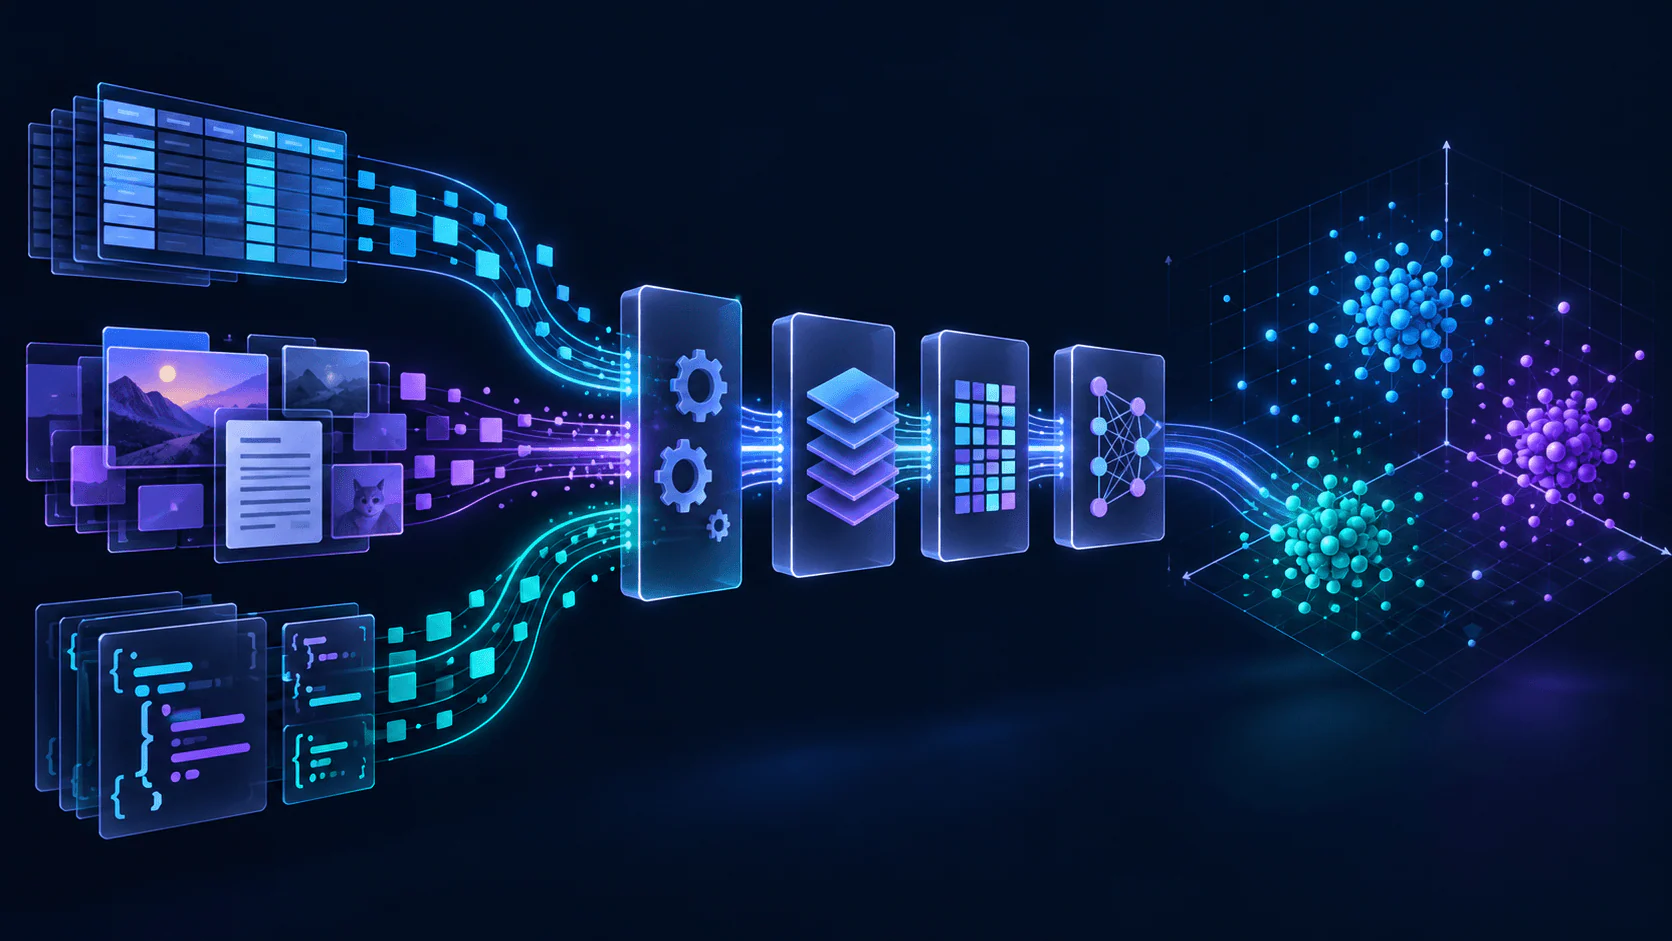
طيب هو المعالجه دي هتتم ازاي علي ال text, images, videos, audio !! فالاخير بيتحولوا لارقام ولكن خد بالك في حاجه ان زمان كانت بتتحول لارقام فقط زي مثلا 10 وده مكنش بيكون بيمثل معني دقيق لكن اكتشفنا حاجه مهمه جدا وهي ال Vectors
ال Vectors!! الي هي المتجهات يعني ؟؟
ايوه بالظبط ال Vectors دي بقا بتمثل الحاجه الي اتعملها processing علي الرسم
برده مش فاهم
بص يسيدي احنا معانا كلمه اسد مثلا فكلمه اسد دي هنحولها ل Vectors يعني هتتحول لمصفوفه فيها مجموعه من الارقام والارقام دي بتعبر عن خصائص أو معنى الحاجة بشكل رياضي "Semantic Meaning" وأشهر نوع من الـ Vectors حاليا هو Embeddings
طيب ده فادنا باي يعني مش فاهم !
هقولك انه فادنا فاننا نقدر نعرف الحاجه القريبه من الاسد فعليا زي مثلا كلمه قطه هنلاقي ان ال Vectors بيتاع الاتنين قريبين من بعض علي الرسم البياني
أشهر نوع من الـ Vectors حاليا هو Embeddings
Written by
Mohamed Alawakey
ML & AI Engineer documenting practical decisions from building RAG, LLM, machine-learning, and FastAPI systems.